
Comment apprennent les réseaux de neurones : les maths derrière une prédiction rapide
Un réseau de neurones est une fonction à paramètres ajustables. L'entraînement mesure l'erreur, calcule des gradients et déplace légèrement les paramètres. Je déroule le tout avec un modèle jouet de prix d'ordinateurs portables : la perte, la descente de gradient avec de vrais chiffres, la rétropropagation, le surapprentissage, et un script de 10 lignes à lancer toi-même.
Sur cette page
TL;DR : Un réseau de neurones est une fonction paramétrée. L’entraînement mesure l’erreur avec une perte, calcule des gradients par rétropropagation, et met à jour les paramètres par descente de gradient. Une faible perte d’entraînement n’est pas le but. La généralisation à de nouvelles données, si. J’utilise un modèle jouet de prix d’ordinateurs portables avec de vrais chiffres pour que le mécanisme reste visible.
Deuxième article d’une série de deux. Le premier traite des prédictions rapides face à l’investigation délibérée.
Dans le premier article, j’ai réparti les décisions entre un modèle prédictif rapide et un processus plus lent et délibéré. Cet article descend d’un niveau : comment un modèle rapide acquiert-il son comportement au départ ?
Je commence par un modèle assez petit pour que les calculs se fassent à la main, puis je monte jusqu’à l’entraînement d’un réseau de neurones.
Un modèle est une fonction à paramètres ajustables
Un programme classique suit des relations que le développeur écrit explicitement. Un modèle d’apprentissage automatique contient des paramètres numériques qu’on ajuste à partir d’exemples. La façon compacte de l’écrire est ŷ = f(x; θ). Ici x est l’entrée, θ l’ensemble des paramètres et ŷ la prédiction.
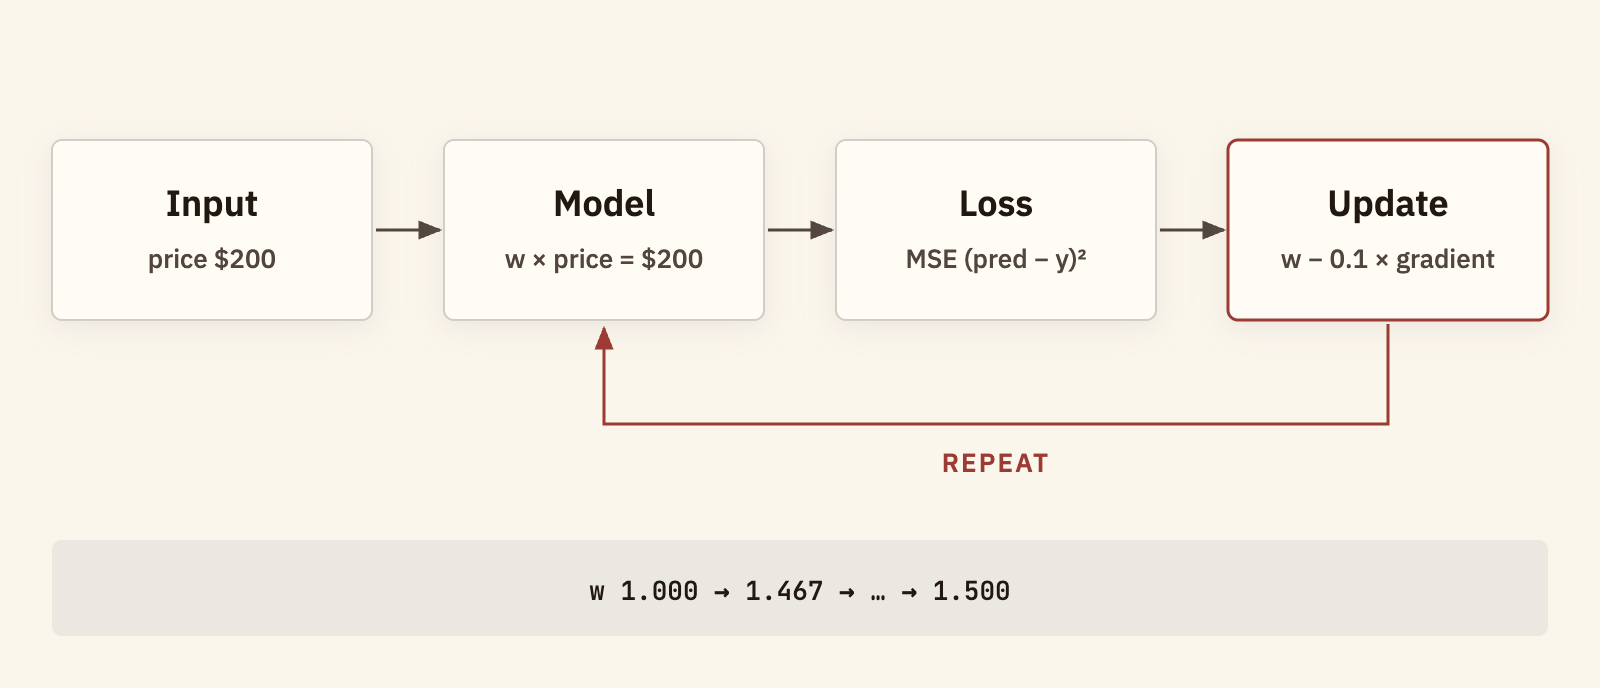
Disons que je veux prédire le prix de revente d’un ordinateur portable à partir de son prix d’achat. J’utilise un modèle volontairement simple : prix de revente prédit = poids × prix d’achat. Un portable acheté 200 $ et revendu 300 $ donne un poids cible de 1,5 pour cet exemple. J’initialise le poids à 1, donc le modèle prédit 200 $. Il se trompe de 100 $, et il me faut un moyen de mesurer cette erreur et de la réduire.
La perte : définir ce qui compte comme une erreur
Une fonction de perte transforme les erreurs de prédiction en un seul nombre à minimiser. Pour des prédictions numériques, l’erreur quadratique moyenne (MSE) fait la moyenne des carrés des écarts entre prédictions et cibles :
MSE = (1/n) × Σ(ŷᵢ − yᵢ)²Le carré empêche les erreurs positives et négatives de s’annuler, et il pénalise davantage les grosses erreurs.
La perte reflète l’objectif d’entraînement que j’ai choisi. Elle ne reflète pas toutes les exigences d’un système en production. Une faible perte d’entraînement ne garantit pas de bonnes prédictions quand les conditions du marché changent.
La descente de gradient : avancer vers une perte plus basse
Le gradient indique à quel point la perte est sensible à chaque paramètre, et dans quel sens. La descente de gradient s’en sert pour mettre à jour chaque poids. En une dimension :
nouveau poids = ancien poids − taux d'apprentissage × gradientPrenons le jeu de données jouet, avec des prix en centaines de dollars : les paires (1 ; 1,5), (2 ; 3) et (3 ; 4,5). La perte vaut alors L(w) = (14/3)(w − 1,5)². Pour w = 1, sa dérivée est d’environ −4,667. Avec un taux d’apprentissage de 0,1, la première mise à jour donne w ≈ 1,467. On est déjà très près de la cible de 1,5.
Le taux d’apprentissage fixe la taille du pas. Trop petit, l’entraînement est lent. Trop grand, il dépasse la cible ou diverge. Les optimiseurs réels reprennent ces idées avec des règles de mise à jour plus fines.
La rétropropagation : des gradients à travers de nombreuses couches
Un vrai réseau a de nombreux paramètres répartis sur des couches. Pendant la passe avant, les données traversent le modèle pour produire une prédiction et une perte. La rétropropagation applique ensuite la règle de dérivation en chaîne pour calculer comment la perte varie par rapport aux paramètres, jusqu’au fond du réseau. L’optimiseur utilise ces gradients pour mettre à jour les paramètres.
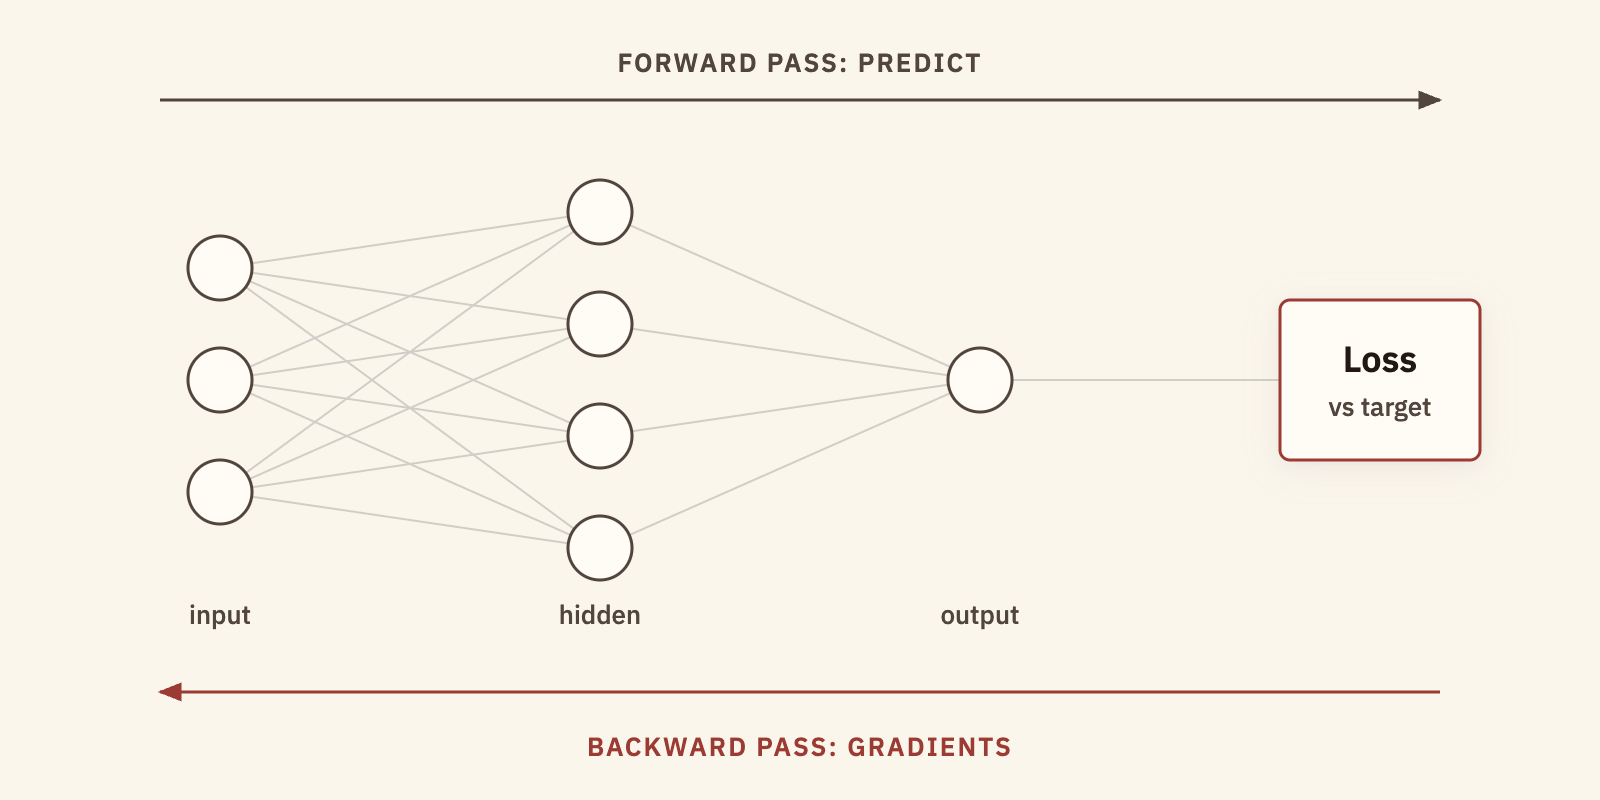
Ce sont deux opérations différentes. La rétropropagation calcule les gradients. La descente de gradient, ou un autre optimiseur, effectue la mise à jour. Des bibliothèques comme PyTorch automatisent la différentiation, et le mécanisme en dessous reste le même.
Une itération d’entraînement minimale ressemble à ceci :
prediction = model(inputs)
loss = loss_function(prediction, targets)
optimizer.zero_grad()
loss.backward()
optimizer.step()
L’entraînement met à jour les paramètres du modèle. L’inférence ordinaire applique les paramètres appris à de nouvelles entrées, sans rien mettre à jour.
Le surapprentissage : une faible perte d’entraînement peut tromper
Imaginons un modèle de prix de revente qui prédit presque parfaitement les portables historiques mais se comporte mal sur ceux qui viennent d’être mis en vente. Il a peut-être appris les particularités de son échantillon d’entraînement plutôt qu’une relation qui tient. C’est le surapprentissage.
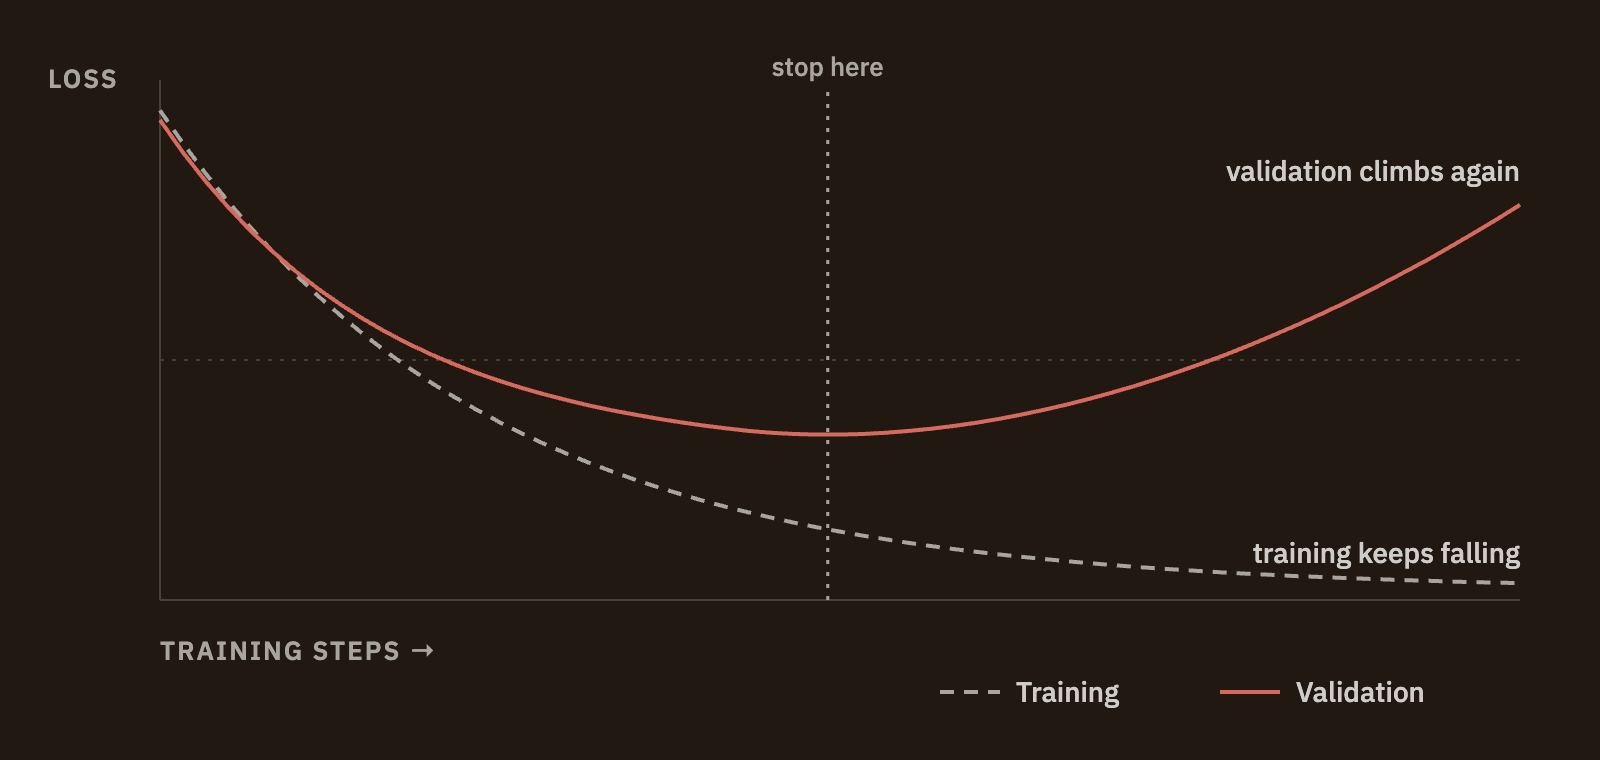
Pour vérifier la généralisation, je garde des jeux d’entraînement, de validation et de test séparés. Les données d’entraînement mettent à jour les paramètres. Les données de validation m’aident à choisir les architectures et les hyperparamètres, et à décider quand m’arrêter. Un jeu de test mis de côté estime la performance finale. Pour des prix qui évoluent dans le temps, un découpage chronologique peut en dire plus qu’un mélange aléatoire de transactions anciennes et récentes.
L’arrêt précoce, la régularisation, des données représentatives et un modèle de la bonne taille aident tous. Aucun ne supprime le besoin d’une évaluation réaliste.
Retour au Système 1 et au Système 2
L’entraînement peut dépenser beaucoup de calcul pour apprendre une correspondance. L’inférence l’applique ensuite rapidement. Les modèles prédictifs spécialisés conviennent donc bien aux tâches répétées et bien définies. Mais un modèle rapide peut échouer sur des entrées inconnues, et il peut se tromper avec assurance. Le processus qui l’entoure peut devoir aller chercher de nouvelles preuves, appliquer des règles de sécurité, ou passer la main à une personne.
Produire un score et décider quelle action ce score justifie sont deux métiers différents.
À lancer toi-même
Voici tout l’exemple jouet en Python pur, sans dépendance de machine learning, pour que le mécanisme d’apprentissage reste visible. Enregistre-le sous train_model.py et lance-le avec Python 3. Il n’est publié nulle part ailleurs sur ce site.
# Basic gradient descent: prices expressed in hundreds of dollars.
data = [(1.0, 1.5), (2.0, 3.0), (3.0, 4.5)]
weight = 1.0
learning_rate = 0.1
for epoch in range(20):
    loss = sum((weight*x-y)**2 for x,y in data)/len(data)
    gradient = sum(2*(weight*x-y)*x for x,y in data)/len(data)
    weight -= learning_rate*gradient
    print(f"epoch={epoch+1:02d} loss={loss:.6f} weight={weight:.6f}")
print(f"Predicted resale for $400 purchase: ${weight*400:.2f}")
Regarde le poids tendre vers 1,5. Essaie ensuite des taux d’apprentissage de 0,001 et de 0,5. Quand je l’ai lancé, 0,001 n’amenait le poids qu’à environ 1,09 au bout de 20 époques, et 0,5 dépassait la cible un peu plus à chaque pas jusqu’à un poids d’environ −10¹¹.
Où j’atterris
Un réseau de neurones est une fonction mathématique paramétrée. L’entraînement mesure les erreurs, calcule des gradients et met à jour les paramètres pour améliorer les prédictions. Ce qui décide si ces prédictions sont utiles, c’est leur généralisation à de nouvelles données, pas leur ajustement à l’ensemble d’entraînement.